微信公众号
手机端

搜索


文/VR陀螺 元桥
当你戴上 AI 眼镜并问一句,“我的钥匙放在了哪里”? AI 眼镜能够回忆起数小时前钥匙放在的位置,并做出提醒。这种酷似人类记忆的能力,便是「空间记忆」。让 AI 眼镜拥有记忆,也是厂商们争相攻破的点。
长久以来,行业都会把 SLAM 当作空间感知的代名词。但谈及 AI 眼镜「空间记忆」会发现一个关键事实,SLAM 解决的是 「我在哪、空间几何长什么样」,而空间智能要回答的是 「这个空间里有什么、发生过什么、对我意味着什么」。
在《SemanticXR:Low Power, Real-time Queryable Semantic Mapping with a Device-Cloud Architecture》这篇论文中,提出了实现 AI 眼镜「空间记忆」的一大关键技术方向—— SemanticXR 。论文认为,真正支撑 AI 眼镜记住现实世界、跨时间唤起场景信息的,是一套融合语义映射、端云协同、对象级地图存储、空间检索引擎的完整体系。本文基于该论文核心观点展开拆解,具体内容如下。
语义建图,把世界拆成一个个可记忆对象
「空间记忆」的本质是把信息、事件锚定到物理空间坐标上,并建立一套位置--对象--时间--语义的关联检索系统,让智能体可以在回到对应的物理场景时,自动召回相关记忆。
这不是单纯的几何建图,也不是普通文本记忆,核心是把空间位置变成记忆的索引键。这便是 SemanticXR 核心范式,将场景里具备语义身份的物体,提升为端云架构中通信、存储、计算的一等单元。
如论文所述,几何建图依靠点云、网格、深度图与 RGB 图像,以 XR 设备采集的数据作为输入,重建环境的三维表征。这类几何地图可以支撑碰撞检测、遮挡剔除、空间距离测算等 XR 基础渲染与空间交互能力。但单纯的几何重建无法承载语义任务,也分辨不出物体类别,亦不能提取物体属性与关联事件信息。
通俗来说,当 XR 设备感知现实环境时,传统重建方案习惯于把房间捕捉成一整片稠密点云,它记录墙面、桌面、角落的几何轮廓,却分不清哪里是杯子、椅子、书本。点云只是一堆空间坐标,没有身份、没有含义,设备 「看见」环境,却不理解环境。
而语义建图的本质,就是打破这种纯几何的环境表达,将物理世界拆解为一个个独立、可被识别、可被记忆的对象。这也是「空间记忆」的基础,不仅知道环境表面位于何处,还能够理解物体之间的从属、空间关联等逻辑关系。
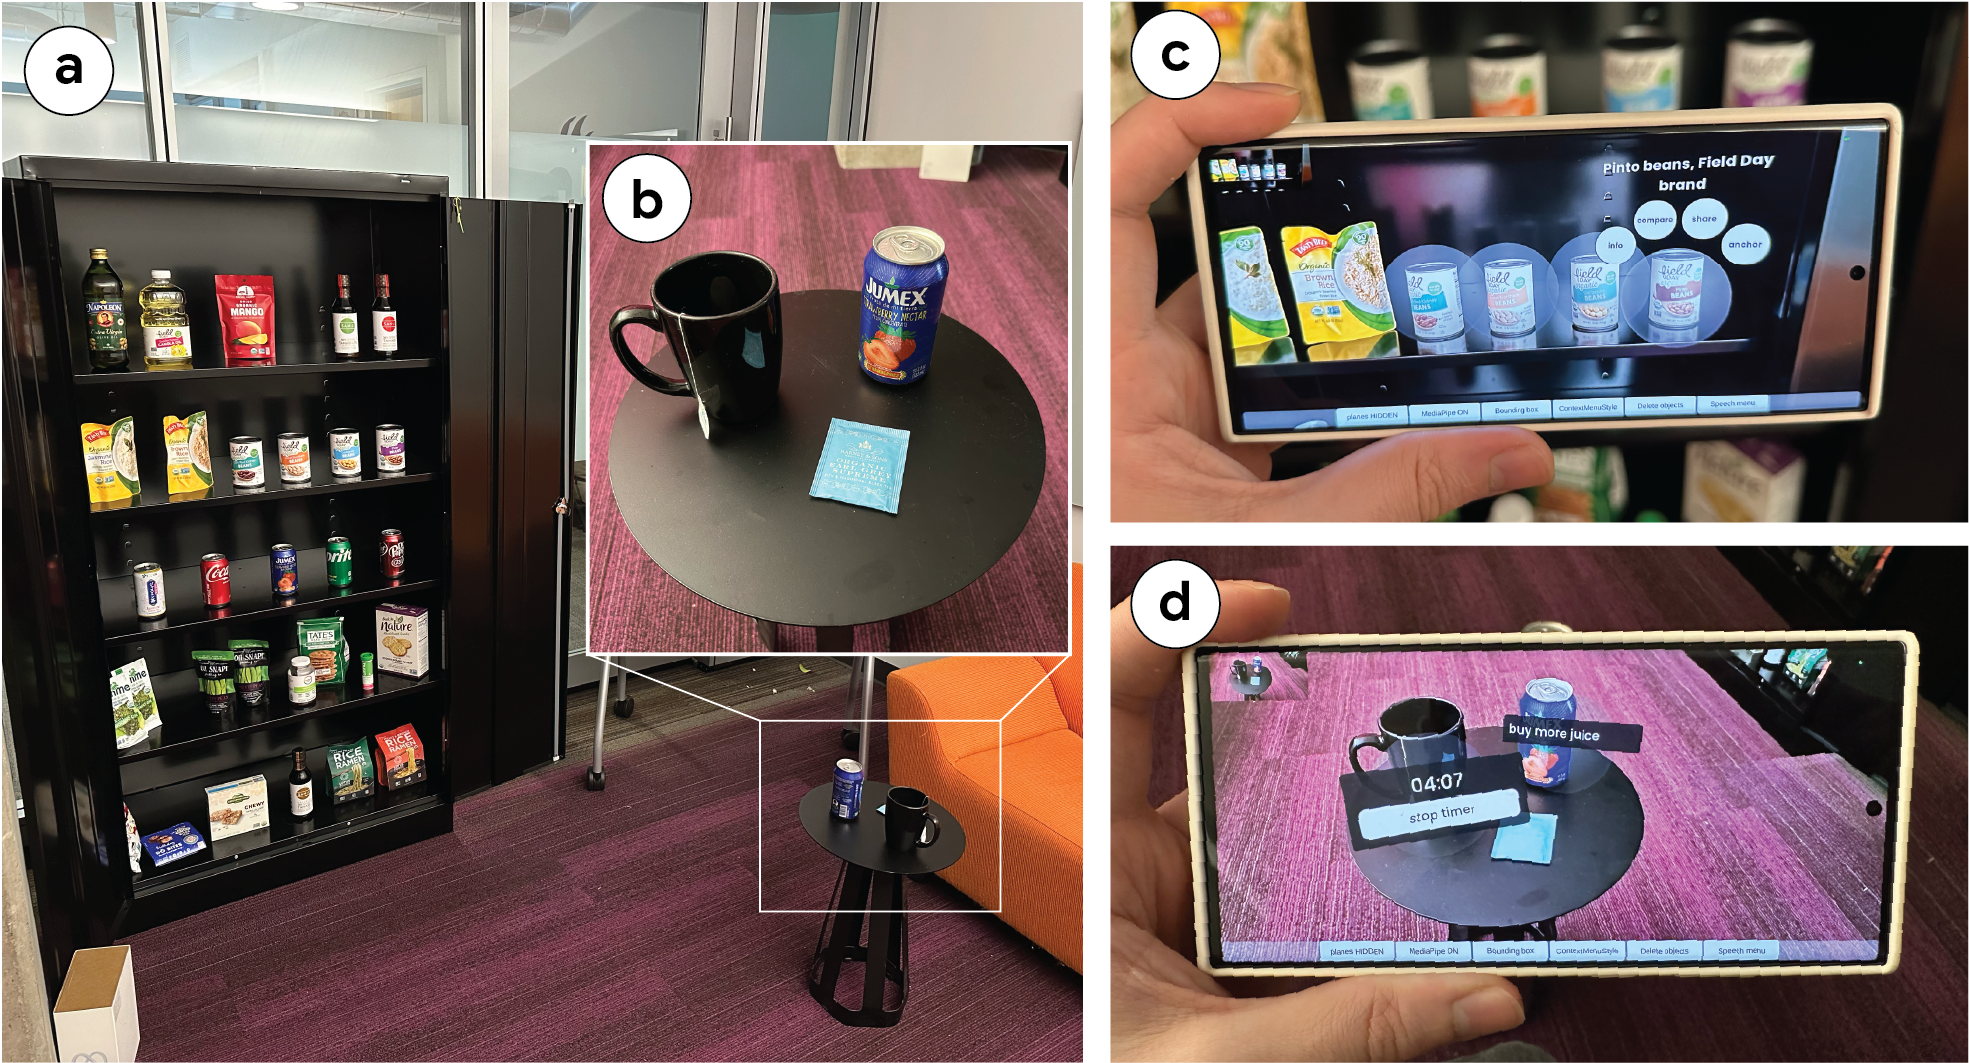
在语义建图体系下,系统不再存储整间屋子的完整稠密点云,而是为每一个独立物体单独维护三维模型、包围盒、空间位置。每个物体都拥有唯一标识,成为独立单元。
物体不再是场景里一堆无差别的像素与点云,而是一个可以被查询、修改、附加信息的对象。我们可以给物体备注标签以及其他多媒体信息,设备能够理解 「这个桌子在房间北侧,桌上放着水杯」,而不是只识别出一片平面与零散点。
其实,人类本身就是这么记忆空间的。
我们回忆一间房间,不会在脑海里重建所有墙面的三维坐标;我们记住的是桌子、台灯、书本,记住它们的位置与相关故事。语义建图,本质是让机器模仿人的空间记忆逻辑:不记住整片空间,记住空间里一个个有意义的对象。
端云协同,解决轻薄 AI 眼镜功耗硬约束
语义建图是支撑 XR 应用虚实融合交互的核心底层服务,将该能力部署在移动端 XR 设备,要求系统同时具备开放词汇、实时响应与低功耗三大特性。开放词汇语义建图需要保证较高的语义识别质量,但不同应用场景对语义质量的需求差异显著,这也为资源动态权衡留下了空间,系统可在计算开销、网络带宽与几何细节之间灵活取舍。
近年视觉与机器人领域算法研究,通过从 2D 基础模型提取语义信息并嵌入三维表征,极大推动了开放词汇语义建图的发展。部分方案依托服务器端 GPU 能够实现实时处理,但算力消耗巨大,很难直接部署在 XR 设备之上。论文提出的 SemanticXR 便可以解决这一难题,作为首个端云协同系统,它能够在移动端 XR 设备功耗、带宽、内存的多重约束下,实现实时开放词汇语义建图与查询。
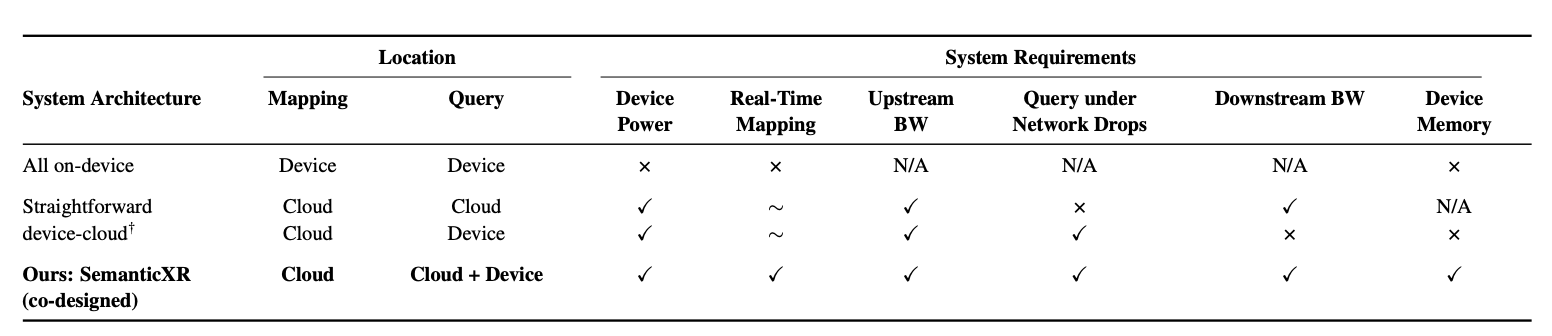
据论文介绍,SemanticXR 采用清晰的端云拆分架构,各模块职责明确,并配套对象级传输与动态调度策略:
**设备端「AI 眼镜」**:负责 VIO 位姿定位,采集 RGB 与深度图像并完成深度下采样,本地维护轻量化稀疏对象地图。弱网条件下依靠本地缓存,可将空间查询延迟稳定控制在 100ms 以内;开启完整语义建图能力后,整机功耗相较空闲状态仅提升 2%。
云端服务器:承载重型计算任务,运行 2D 基础模型、执行 3D 语义建图,以物体为单位并行完成语义特征提取。
对象级稀疏传输:摒弃原始视频流传输,终端仅上传检测识别出的物体信息,上行带宽可控制在 2.5Mbps 以内,大幅降低传输压力。
更新优先级调度:面对网络波动,系统设置任务优先级:优先响应用户的空间查询请求,将非紧急的地图增量更新延后处理,保障人机交互流畅不卡顿。
在保持同等语义质量的前提下,SemanticXR 将建图吞吐量提升 2.2 倍,同时把上行带宽控制至 2.5Mbps。面对网络波动环境,系统可支持上万物体,查询延迟稳定在 100ms 以内;下行带宽仅随地图内发生变更的物体数量增长,而不随整个场景的规模膨胀。相较设备空闲状态,SemanticXR 仅带来约 2% 的额外功耗增量。
为进一步验证 SemanticXR 的可行性,论文还专门开展了端侧部署测试,并以 Meta Quest 3 与 Apple iPad Pro 为例进行验证:iPad 端借助 ARKit 获取 RGB 图像、深度图与设备位置;Quest 3 端则基于 Meta 透视相机与深度 API 采集 RGB 图像、深度图及头显位置,整套原型基于 Unity 引擎开发。
两台设备均以流式方式将部分采集帧上传至服务器,完成匹配与建图;同时 SemanticXR 开放可调节参数接口,用于系统控制。iPad 端传输经 H.264 编码的 RGB 图像「分辨率 720×1280,码率 5Mbps」,附带低分辨率深度与位置数据「144×256」;Quest 3 端传输未压缩 RGB 图像、位置及深度图「20×320」。在空间查询场景中,客户端下发查询指令,服务器完成解析并检索语义地图,返回匹配的物体点云,完成渲染。
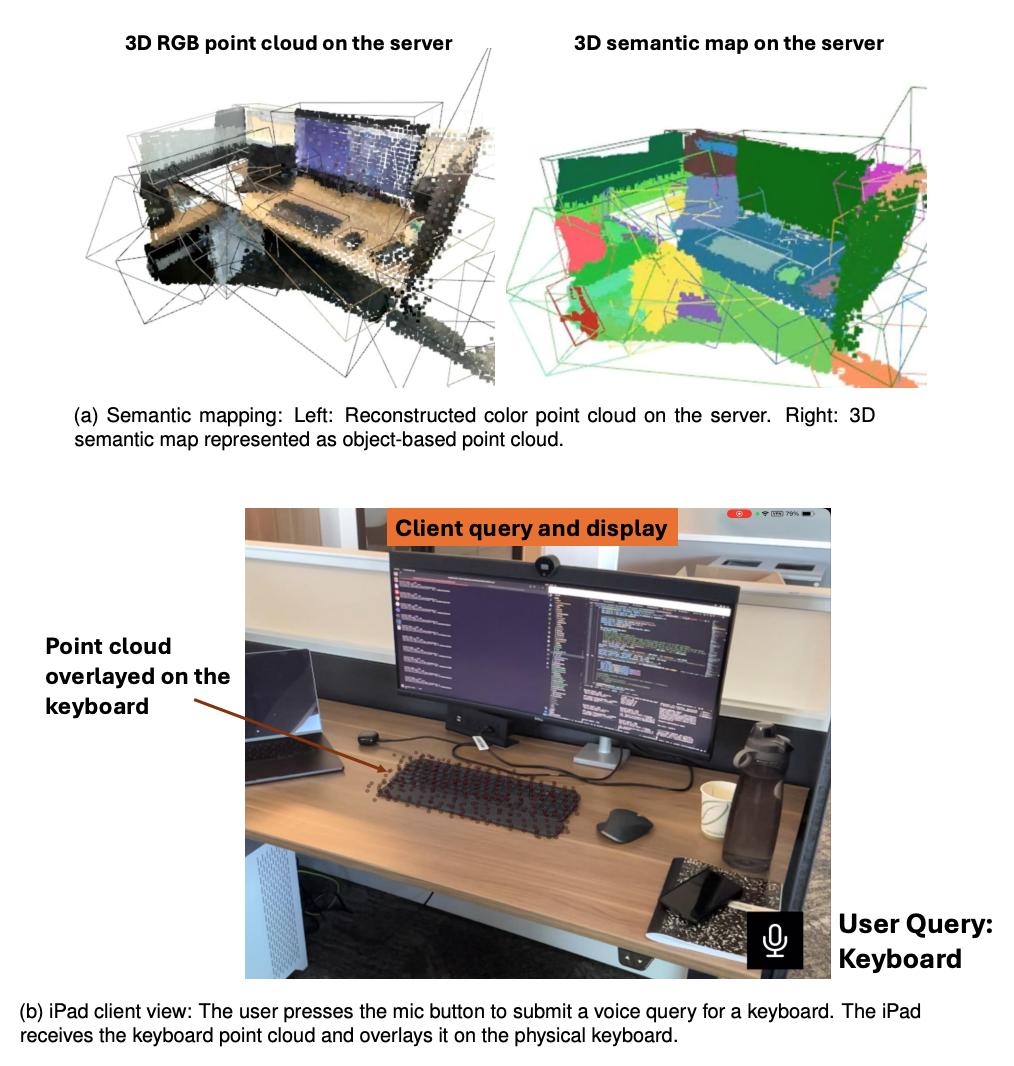
iPad 端部署效果,服务器增量式构建语义地图,客户端对查询目标物体进行可视化渲染
本次部署完成了真实移动端硬件端到端验证,覆盖了商用 XR 、实时光学传感器与交互查询全链路,验证了 SemanticXR 轻量化客户端可直接运行到移动端传感器上。
结语
SemanticXR 之所以能让客户端直接跑在传感器端,关键还是在于其将「重计算」与「轻交互」做了彻底的解耦。
重活在云端:复杂的语义映射和模型推理「如 CLIP 嵌入生成、物体级并行处理」都在服务器完成,利用了云端的强大算力。轻活在端侧:设备端仅维护一个物体级的稀疏局部地图,只接收和存储与当前场景相关的增量更新,而不是整个场景的稠密数据。这样一来,下行带宽只与地图变化有关,而非场景总大小,从而极大降低了对端侧存储和网络的依赖。
如今,AI 眼镜正在经历从 「看见世界」到 「理解世界」的关键跃迁。我们期待下一代 AI 眼镜不仅是一块可透视的显示屏,而是更为智能的生活助理,能够听懂我们的语言并在对应的物理环境下给出恰当的反馈。
只是若想实现 AI 眼镜真正智能化体验技术上还是存在很多局限,Semantic XR 提供了一条可行的参考技术路线,虽然目前更多是一项前沿学术原型,距离大规模消费产品落地仍有距离,但或许将会成为 AI 眼镜拥有「空间记忆」的关键技术方向。
投稿/爆料:tougao@youxituoluo.com
稿件/商务合作: 林南(微信 19250561593)
加入行业交流群:林南(微信 19250561593)
版权申明:本文为VR陀螺原创,任何第三方未经授权不得转载。如需转载请联系微信:vrtuoluo233 申请授权,并在转载时保留转载来源、作者以及原文链接信息,不得擅自更改内容,违规转载法律必究。文中有图片、视频素材来自互联网或无法核实出处,如涉及版权问题,请联系本网站协商处理。
元宇宙数字产业服务平台
下载「陀螺科技」APP,获取前沿深度元宇宙讯息